10 de octubre de 2026 · 4 min de lectura
transcribe: de una nota de voz a una herramienta open source para la terminal
Necesitaba pasar una nota de voz a texto sin subirla a ningún lado. Esa misma noche el script de diez líneas terminó siendo una CLI interactiva con subtítulos, tests y licencia MIT.
En este artículo
Todo empezó con una nota de voz de WhatsApp que tenía que convertir en texto, rápido. Lo resolví en segundos con Whisper en la nube, pero me quedó la duda: ¿por qué un audio personal tiene que salir de mi computadora para algo que mi propia laptop puede hacer?
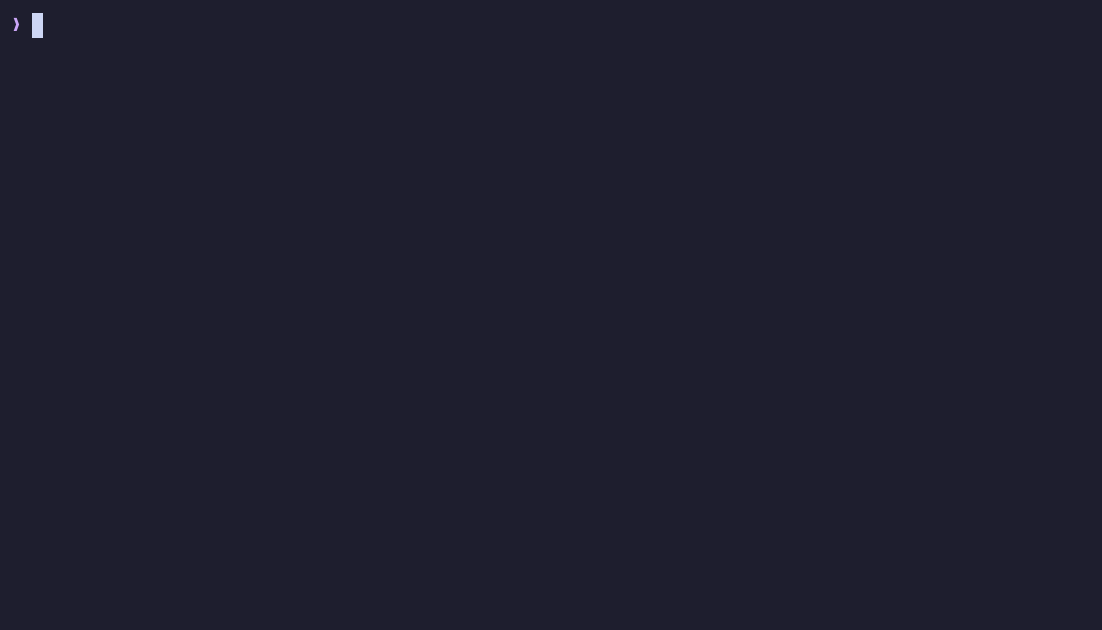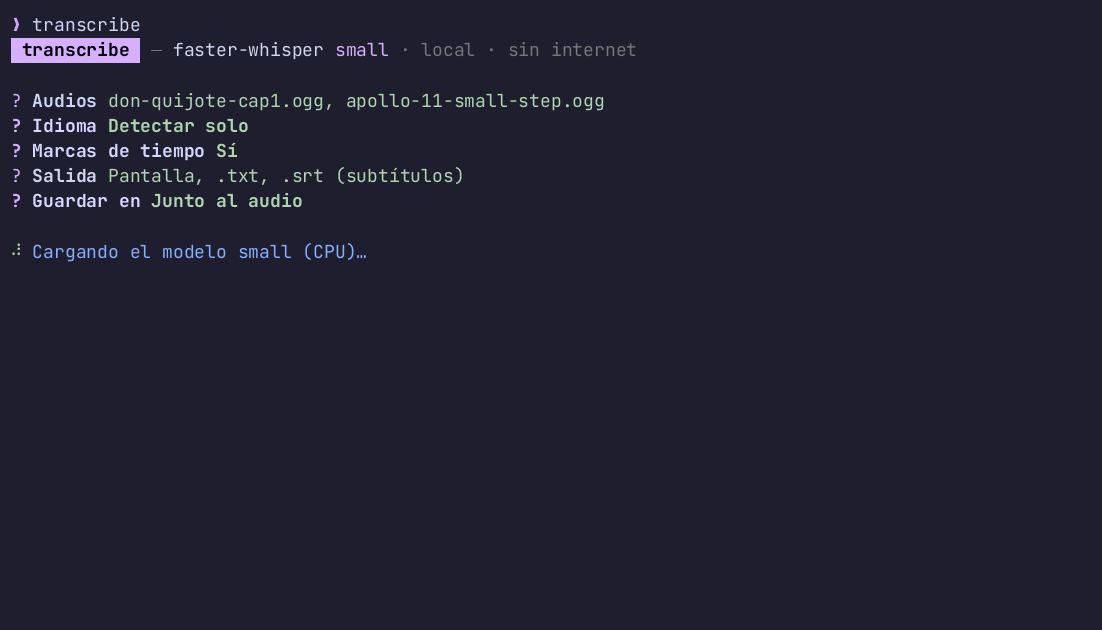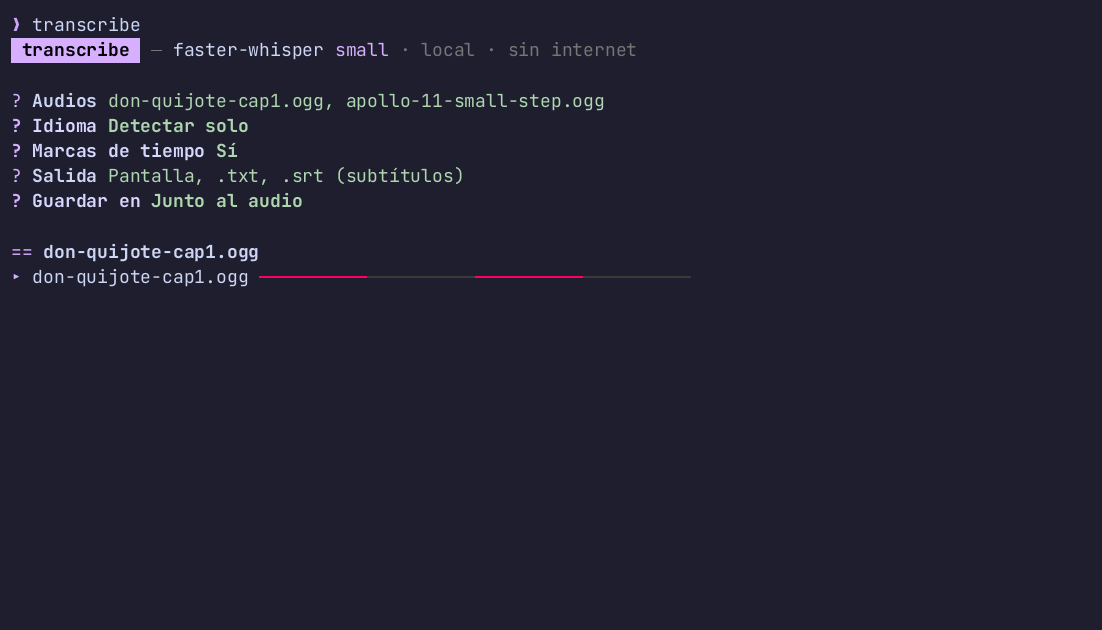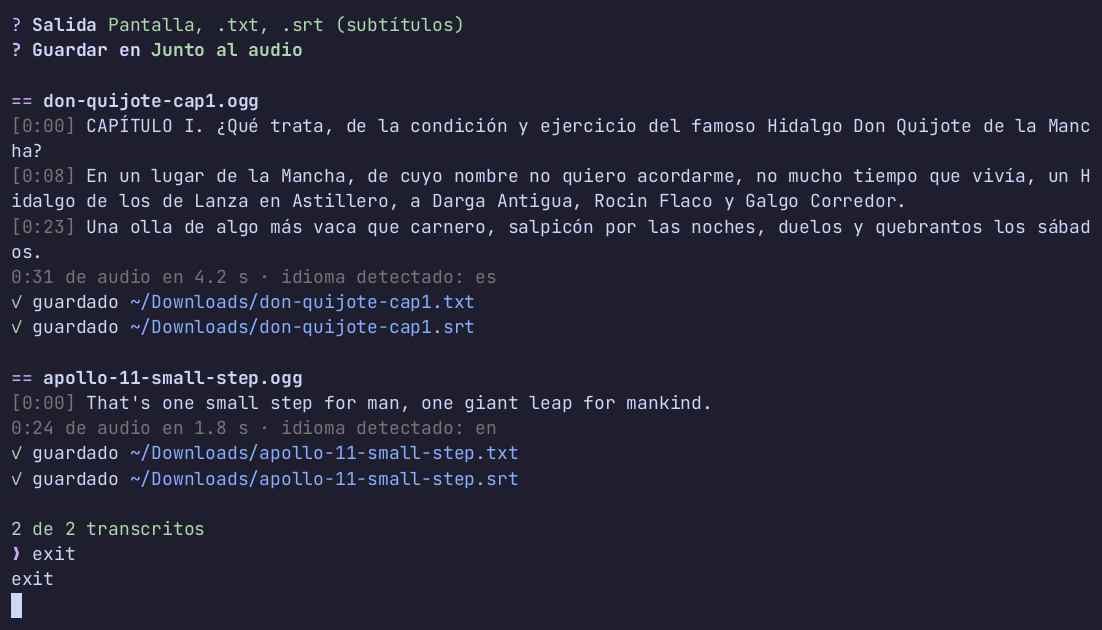
Esa misma noche armé transcribe: eliges audios o videos en un menú de la terminal y sale el texto, con marcas de tiempo o subtítulos si los quieres. Todo local, sin cuentas ni claves de API.
El primer script y el primer error
La primera versión eran diez líneas con faster-whisper, una versión optimizada de Whisper que corre bien en CPU. Lo instalé, lo ejecuté y… error:
TypeError: open() got an unexpected keyword argument 'metadata_errors'faster-whisper usa PyAV para leer el audio, y la versión de PyAV que instaló pip no coincidía con la que espera faster-whisper. En vez de pelear con versiones, le saqué esa responsabilidad: ahora el audio lo decodifica el ffmpeg del sistema, que lo convierte a mono de 16 kHz y se lo pasa al modelo como un arreglo de números. De paso ganó algo que no estaba buscando: lee cualquier formato, incluido el audio de un video.
¿Hace falta un modelo más grande?
Con el modelo small, en la CPU de mi laptop, una nota de voz de 30 segundos tarda unos 3 segundos: unas 10 veces más rápido que el tiempo real. La transcripción salía bien salvo por una palabra cariñosa dicha muy rápido al principio del audio.
La tentación era bajar un modelo más grande. Antes de hacerlo comparé, y el modelo grande (large-v3, el mismo que usé en la nube) también se equivocaba en esa palabra. También probé darle contexto con palabras esperadas: corrigió otras dos, pero se comió el saludo del inicio. Conclusión: para notas de voz, small alcanza, y bajar 3 GB no iba a arreglar ese caso.
Una GPU que se ve pero no funciona
Mi laptop tiene una RTX 5070 Laptop. CTranslate2 (el motor de faster-whisper) la detectaba, así que probé usarla. El modelo cargó sin problema… y falló recién al transcribir:
RuntimeError: Library libcublas.so.12 is not found or cannot be loadedFaltaban las librerías de CUDA. Si dejaba la GPU como opción automática, cualquiera con una tarjeta NVIDIA sin CUDA vería un error o, en el mejor caso, una advertencia en cada ejecución. La solución tiene dos partes:
- Antes de elegir la GPU, comprobar que la librería de CUDA se pueda cargar de verdad. Si no, ir directo a la CPU, sin advertencias.
- Si igual falla a mitad de camino, atrapar el error una sola vez, recargar el modelo en la CPU y seguir.
De script a herramienta
Ya que funcionaba, quise usarlo sin escribir rutas largas. Corriendo transcribe sin argumentos aparece un menú:
- Tus Descargas, de lo más nuevo a lo más viejo, con la duración y la antigüedad de cada archivo. Escribes para filtrar y marcas varios con espacio.
- Buscar en toda la máquina: tu carpeta personal y los discos montados, con fd, saltando carpetas ocultas, cachés y
node_modules. - Después: idioma (español, inglés o detectar solo), marcas de tiempo, salida (pantalla,
.txt,.srt) y dónde guardar.
Todo eso también existe como flags (-o, -t, --srt, -l…) para usarlo en scripts. Mientras transcribe, el texto aparece línea por línea con una barra de progreso, y la interfaz sale en español o inglés según el idioma del sistema.
Probarlo como un usuario de verdad encontró cosas que los tests no veían. Lo manejé desde tmux, mandando teclas y capturando la pantalla, y apareció un error: el filtro de búsqueda de la librería de menús (questionary) solo funciona con títulos de texto plano, y yo le pasaba texto con colores. También salía un “done (2 selections)” en inglés aunque la interfaz estuviera en español, así que ese resumen ahora lo escribe la propia app.
Abrirlo
Publicarlo me obligó a dejarlo prolijo:
- 29 tests que no descargan nada: usan un modelo falso, y el del cambio de GPU a CPU simula justo el error de
libcublas. - CI en GitHub Actions con tres versiones de Python.
- Ningún audio personal en el repositorio: el
.gitignorebloquea grabaciones fuera de la carpeta de demo, y la demo usa audios de dominio público (el “One small step” del Apolo 11 y el comienzo del Quijote en LibriVox). - README en inglés y en español, notas de arquitectura y el GIF que ves arriba, grabado con asciinema.
Está en github.com/rossmelabasto/ross_transcribe con licencia MIT, y se instala con un comando:
pipx install git+https://github.com/rossmelabasto/ross_transcribeLo que me llevo
- Medir antes de agrandar. El modelo grande no arreglaba el error que quería arreglar; comparar me ahorró gigas y tiempo.
- Probar en el hardware real. “La GPU se detecta” y “la GPU funciona” no son lo mismo, y solo lo vi probándolo en mi laptop.
- Usar lo que uno hace. Manejar la interfaz como un usuario encontró un error que ningún test cubría.
Si lo pruebas con tus audios, me encantaría saber cómo te va.